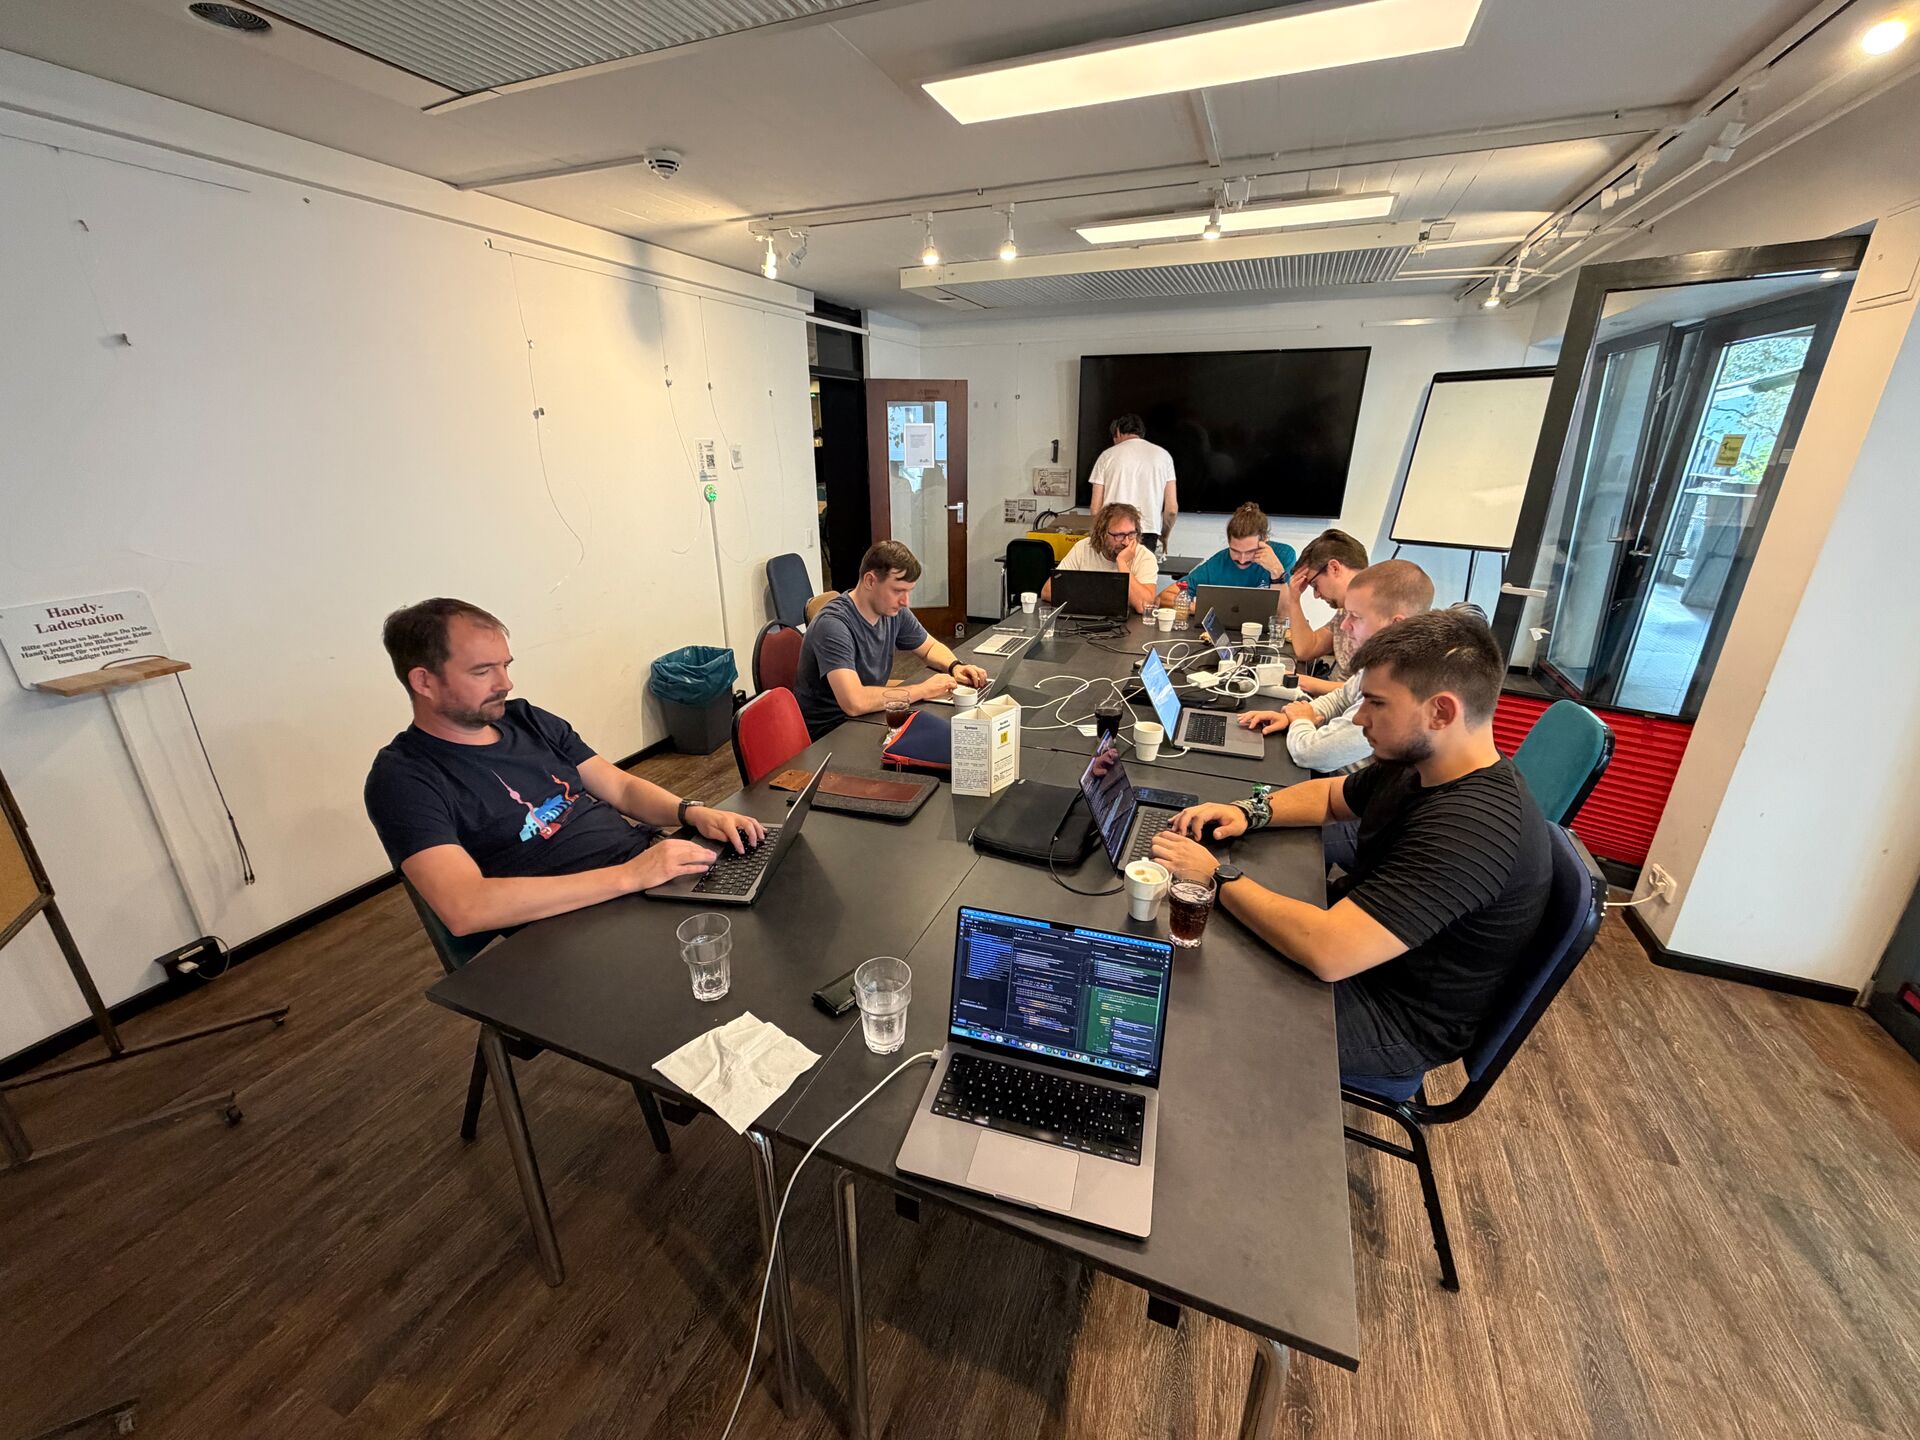
Jedes Jahr trifft sich das Contao Core-Entwicklerteam zweimal für einen kurzen Code-Sprint von vier Tagen. Getroffen
haben wir uns dieses Mal wieder im Unperfekthaus in Essen.
Obligatorischer Hinweis: Die Entwicklertreffen sind für die Weiterentwicklung von Contao entscheidend und daher
mache ich wie immer darauf aufmerksam, dass die Contao Association diese Treffen finanziert. Als
Supporter kannst du deinen Teil dazu beitragen.
Jetzt zu neunt
Offenbar hat ihn das Treffen im Frühjahr nicht genügend abgeschreckt, denn zu unserer grossen Freude war Lukas
Bableck erneut mit dabei. Zu Beginn des Treffens waren wir damit acht Core-Entwickler plus Lukas und haben vier Tage
lang quasi ununterbrochen an Contao gearbeitet.
Diese Rechnung stimmt seit Mittwoch Abend allerdings nicht mehr: Wir haben Lukas ins Core-Team aufgenommen! Wer sich
seine zahlreichen Beiträge der letzten Monate anschaut, dürfte davon nicht völlig überrascht sein. Lieber Lukas,
herzlich willkommen im Core-Team! Wir freuen uns sehr, dass du dabei bist! Ab jetzt sind wir also neun
Core-Entwickler.
Wer mehr über Lukas erfahren möchte, findet ihn übrigens auch im Format «Wir sind Contao».
Eine neue Realität
Traditionell beginnen unsere Entwicklertreffen am Sonntagabend mit den grossen Themen. Noch bevor am Montag die
ersten Pull Requests entstehen, diskutieren wir darüber, wo wir mit Contao überhaupt hinwollen. Normalerweise lautet
die Frage dann ungefähr: «What's next?» Dieses Mal war sie eher: «Was passiert hier eigentlich gerade?»
Zwischen unseren beiden Treffen liegen nur ein paar Monate und trotzdem hat sich die Art und Weise, wie wir Code
schreiben, in dieser kurzen Zeit gefühlt einmal komplett um 180 Grad gedreht. KI-gestützte Werkzeuge sind von
interessanten Experimenten zu täglichen Begleitern geworden. Sie erklären Code, schreiben Tests, finden Fehler und
übernehmen Aufgaben, für die wir vor wenigen Monaten noch Stunden oder Tage eingeplant hätten. Und während ich diese
Zeilen schreibe, ist das hier vermutlich bereits wieder veraltet.
Einerseits ist das grossartig. Als Open-Source-Projekt mit begrenzten Ressourcen können wir plötzlich Dinge angehen,
die bisher aus den unterschiedlichsten Gründen liegen geblieben sind. Fehlende Zeit war einer davon. Das macht
Spass, setzt unglaublich viel Energie frei und erklärt sicher auch einen Teil der absurden Menge an Pull Requests an
diesem Treffen.
Andererseits wäre es unehrlich, nur von Euphorie zu schreiben. Wir sassen da als Gruppe von erfahrenen
Entwicklern und stellten plötzlich Dinge infrage, die über Jahre selbstverständlich waren. Welche Fähigkeiten
braucht es künftig noch? Wie sieht unser Beruf in ein paar Jahren aus? Wozu braucht es überhaupt noch ein
Content-Management-System,
wenn sich Inhalte und Anwendungen scheinbar auf Zuruf erzeugen lassen? Wozu noch Contao? Und, wenn man die Frage
ganz zu Ende denkt: Wozu überhaupt noch irgendetwas als Entwickler tun?
Mit diesen Fragen sind wir weder allein noch betreffen sie nur Contao. Die gesamte Softwarebranche versucht gerade,
die Folgen dieser Entwicklung einzuordnen. Und ja, das war stellenweise auch ziemlich verunsichernd.
Eine abschliessende Antwort haben wir selbstverständlich nicht gefunden. Dafür verändert sich gerade zu viel und zu
schnell. Aber eines war für uns nach vielen Stunden Diskussion klar: Den Kopf in den Sand zu stecken, ist keine
Option. Wir wollen diese Veränderung nicht bloss beobachten, sondern aktiv mitgestalten.
Und vielleicht ist ein CMS gerade in dieser neuen Realität wichtiger, als es auf den ersten Blick scheint. Nur weil
Inhalte automatisch erzeugt werden können, verschwinden Struktur, Zuständigkeiten, Berechtigungen und verlässliche
Quellen ja nicht. Im Gegenteil. Je mehr Systeme Inhalte erzeugen und verarbeiten, desto wichtiger wird ein Ort, der
weiss, was gültig ist, wer etwas verändern darf und wie alles zusammengehört.
Genau diese Rolle kann Contao einnehmen: Eine verlässliche Schaltzentrale, über die Menschen und Maschinen gemeinsam
mit Inhalten arbeiten können. Natürlich ohne Sicherheit, Kontrolle, Erweiterbarkeit und Stabilität aufzugeben.
Ob das die endgültige Antwort ist? Sicher nicht. Aber es ist eine Richtung, mit der wir arbeiten können. Und damit
wären wir beim Hauptthema dieses Treffens.
API und MCP
Für die Contao-6-Reihe hatten wir bereits angekündigt, den Fokus auf API und Model Context Protocol, kurz MCP, zu
legen. Dass Contao eine API braucht, wissen wir schliesslich seit Jahren. Bevor sie sinnvoll und sicher möglich
wurde, mussten wir jedoch zahlreiche interne Baustellen angehen.
Über die gesamte 5er-Reihe entstanden dafür entscheidende Grundlagen: das Berechtigungssystem in der DC_Table,
reloadable DCAs und der DcaRequestSwitcher. Der Wechsel von Input- zu Output-Encoding sorgt dafür, dass in der
Datenbank die tatsächlichen Werte liegen. Der dafür notwendige Umstieg auf Twig machte wiederum zusätzliche
Werkzeuge nötig: das Template Studio sowie zahlreiche Contao-spezifische Filter und Funktionen. All diese
Anstrengungen zahlen nun auf API und MCP ein. Jetzt wird aus dem langjährigen Wunsch endlich Realität.
Ganz bei null angefangen haben wir in Essen nicht. In den Wochen und Monaten davor hatte ich bereits an den ersten
Versionen des API-Bundles, des MCP-Bundles sowie an der Basis für unser End-to-End-Testing gearbeitet und diese
Grundlagen mit ans Treffen gebracht. So konnten wir die vier Tage nutzen, um gemeinsam direkt darauf aufzubauen.
Was in diesen vier Tagen daraus entstanden ist, hat uns dann aber doch selbst überrascht. Wir haben API und MCP nicht
nur an unzähligen Stellen erweitert und miteinander verbunden. Aus den Anforderungen sind mit dem OAuth-Server-Bundle
und der Grundlage für ein künftiges Webhooks-Bundle gleich zwei weitere eigenständige Bausteine entstanden. Mit drei
vorbereiteten Grundlagen anreisen und mit zwei zusätzlichen Bausteinen wieder nach Hause fahren? Schon ziemlich
beeindruckend, was als Team in vier Tagen möglich ist!
Warum eine API gerade jetzt so wichtig ist
Eine moderne API ermöglicht es anderen Anwendungen, strukturiert und kontrolliert mit Contao zu kommunizieren. Klar,
APIs wurden nicht erst wegen KI erfunden. Headless-Websites, Mobile Apps, Automatisierungen und Drittsysteme
profitieren alle davon, wenn Inhalte über eine klar definierte Schnittstelle erreichbar sind.
Mit KI verändert sich die Dringlichkeit aber erheblich. Wenn ein Agent Inhalte finden, Templates anpassen oder
eine Website kontrollieren soll, braucht er Kontext. Und der sollte nicht aus direkten Datenbankzugriffen oder einem
Sammelsurium projektspezifischer Scripts kommen, sondern aus einer Schnittstelle, die Contao versteht.
Noch wichtiger: Diese Schnittstelle muss nicht nur Daten, sondern auch Regeln kennen. Ein Backend-Benutzer darf
schliesslich auch nicht automatisch alle Seiten bearbeiten, alle Dateien sehen oder jede Operation ausführen. Warum
sollte ein KI-Assistent mehr dürfen? Genau dieselben Berechtigungen müssen auch dann gelten, wenn der Zugriff über
eine API oder ein KI-gestütztes Werkzeug erfolgt. Die API ist deshalb nicht bloss eine andere Darstellung unserer
Datenbank. Sie ist eine kontrollierte Eingangstür zu den Fähigkeiten von Contao.
An dieser Eingangstür haben wir während des Treffens intensiv gearbeitet.
Von Tabellen zu echten Contao-Ressourcen
Die DataContainer beschreiben Felder, Operationen, Relationen und Berechtigungen. Da steckt also bereits fast alles
drin, was wir auch für eine API brauchen. Das ist super, weil wir nicht für jede Tabelle eine eigene Schnittstelle
bauen müssen und Extensions sich in die gleichen Mechanismen einklinken können.
«Tabelle rein, JSON raus, Feierabend» funktioniert natürlich trotzdem nicht. Seiten bilden einen Baum, Artikel
gehören zu Seiten, Inhaltselemente können selbst wieder verschachtelt sein und zahlreiche Datensätze referenzieren
andere Ressourcen. Die API muss all diese Zusammenhänge verstehen. Wäre ja sonst auch zu einfach.
Und genau hier haben wir grosse Fortschritte erzielt. Die DataContainer-API bildet nun auch Hierarchien ab und löst
Relationen als eindeutige Ressourcen-Referenzen auf. Sortieren, Verschieben, verschachtelte Inhaltselemente,
Datumsfelder, Beschreibungen aus der DCA usw. Alles Dinge, die einzeln vielleicht unspektakulär klingen, in Summe
aber den Unterschied zwischen «Wir liefern Daten aus» und einer API machen, welche die Konzepte und Zusammenhänge
von Contao korrekt abbildet.
Das Virtual Filesystem ist über die API erreichbar. Dateien sind in Contao schliesslich weit mehr als
Pfade auf irgendeiner Festplatte. Das VFS kennt öffentliche und geschützte Dateien, Metadaten, Mounts und
unterschiedliche Speicherorte. Genau deswegen haben wir dieses Ding ja gebaut. Ein Client muss und soll nicht
wissen, auf welchem konkreten Dateisystem eine Datei liegt.
Bis zum Ende des Treffens kamen noch weitere wichtige Details dazu. Datei-Uploads funktionieren jetzt auch über die
generischen MCP-Werkzeuge und respektieren dabei die konfigurierten Grössenlimits. Ein Assistent kann uns also nicht
einfach unbemerkt ein mehrere Gigabyte grosses Geschenk machen. Der Download von Dateien über API und MCP sowie die
Unterstützung von Datei-UUIDs waren am Mittwochabend ebenfalls bereits in Arbeit.
Dasselbe gilt für das Template Studio. Templates lassen sich über definierte Endpunkte finden, lesen, erstellen und
bearbeiten. Die vorhandenen Operationen und Metadaten des Template Studios werden dabei weiterverwendet. Wir bauen
also keine zweite, vereinfachte Template-Welt neben dem Backend auf, sondern machen die bereits vorhandenen
Fähigkeiten kontrolliert von aussen zugänglich.
Authentifizierung und Sicherheit
Eine API mit Schreibzugriff ist nur dann nützlich, wenn wir ihrer Absicherung genauso viel Aufmerksamkeit schenken
wie ihren Funktionen. Sonst haben wir eine tolle neue Schnittstelle und gleich auch ein tolles neues
Sicherheitsproblem. Entsprechend viel Arbeit floss in die Authentifizierung.
Das am Treffen neu entstandene OAuth-Server-Bundle ermöglicht vor allem MCP-Clients einen standardisierten
Autorisierungsprozess. Für direkte API-Zugriffe arbeiten wir parallel an persönlichen Zugriffstokens für
Backend-Benutzer, die einfacher widerrufen werden können als ein Benutzerpasswort.
Entscheidend ist: Nach der erfolgreichen Authentifizierung greifen weiterhin die Berechtigungen des jeweiligen
Benutzers. Die API darf keine Abkürzung an der Sicherheitslogik vorbei sein. Ein grosser Teil der Arbeit am Treffen
floss deshalb in Berechtigungen, Authentifizierung und ein konsistentes Verhalten ausserhalb normaler
Backend-Requests. Nicht unbedingt die Dinge, die sich auf einem Screenshot wahnsinnig gut verkaufen, aber eben
genau die Arbeit, die am Ende den Unterschied macht.
MCP in Contao
MCP hat sich in kürzester Zeit als Standard etabliert, über den Anwendungen KI-Assistenten Werkzeuge und Kontext zur
Verfügung stellen. Ein MCP-Server beschreibt, was ein Assistent tun darf und welche Informationen er dafür erhält.
Er muss die Besonderheiten von Contao dadurch nicht erraten und wir müssen nicht für jedes Projekt eine
Spezialintegration bauen.
MCP baut bei uns auf der API und den vorhandenen Contao-Services auf. Alles andere wäre auch ziemlicher Unsinn, denn
wir wollen die fachliche Logik ja nur einmal sauber implementieren. Ob eine Aktion anschliessend aus dem Backend,
über die API oder durch ein MCP-Werkzeug ausgelöst wird, darf für Berechtigungen und Datenintegrität keinen
Unterschied machen.
Ein erstes Werkzeug bindet die Backend-Suche an. Ein Assistent kann damit nicht nur irgendwelche Datenbankzeilen
durchsuchen, sondern jene Resultate finden, die auch dem angemeldeten Benutzer zur Verfügung stehen. Weitere
Werkzeuge können Templates entdecken, lesen, validieren und verwalten. Sie wissen, welche Templates andere
Templates überschreiben oder erweitern und können dadurch die Auswirkungen einer Änderung wesentlich besser
einschätzen. Dazu kommt Guidance für den Umgang mit Contao. Template-Snapshots stehen nicht nur über MCP, sondern
auch in der Benutzeroberfläche zur Verfügung.
Gerade beim Template Studio zeigt sich sehr schön, wohin die Reise gehen kann. Statt einem Assistenten bloss den
Inhalt einer einzelnen Datei hinzuwerfen, können wir ihm den tatsächlichen Contao-Kontext liefern: Welches Theme ist
aktiv? Welches Original wird überschrieben? Welche Blöcke stehen zur Verfügung? Und welche anderen Templates sind
von einer Änderung betroffen? So kann der Assistent Änderungen auf Grundlage des tatsächlichen Contao-Kontexts
vornehmen.
Ein weiteres MCP-Werkzeug bindet die Frontend-Vorschau an. Damit kann ein Assistent beispielsweise ein Bild im
richtigen Dateisystem finden, ein Template anpassen und das unveröffentlichte Resultat anschliessend in der Vorschau
kontrollieren. So entsteht ein Mini-Workflow. Das klingt bereits sehr mächtig und genau
deshalb sind klare Grenzen, Berechtigungen und gute Tests so wichtig.
Der aktuelle Stand ist bereits so weit, dass wir diese Funktionen voraussichtlich mit Contao 6.1 ausliefern können.
Danach können wir sie schrittweise ausbauen und aufgrund des Feedbacks aus der Community verbessern.
Insgesamt sind an diesem Treffen über 100 Pull Requests zusammengekommen.
Webhooks: Wenn Contao mit anderen Systemen spricht
Wo wir gerade bei der Kommunikation mit anderen Systemen sind: Lukas hat während des Treffens mal eben die Grundlage
für eingehende und ausgehende Webhooks geschaffen. Webhooks ermöglichen es Systemen, automatisch auf Ereignisse zu
reagieren, ohne ständig aktiv nach Änderungen fragen zu müssen.
Contao soll künftig einerseits Ereignisse von externen Diensten empfangen und andererseits eigene Ereignisse sicher
an angebundene Systeme versenden können. Die Verarbeitung erfolgt asynchron über den Symfony Messenger. Dazu kommen
unter anderem signierte Anfragen, verschlüsselt gespeicherte Secrets, Rate Limits und Schutzmechanismen für
ausgehende Verbindungen. Im Backend lassen sich Endpunkte und Abonnements konfigurieren.
Die Umsetzung ist noch nicht abgeschlossen, bildet aber bereits eine erstaunlich umfangreiche Grundlage. Welche
Ereignisse der Core selbst anbieten wird und wie flexibel sich eigene Payloads konfigurieren lassen sollen, müssen
wir in den nächsten Schritten klären. Aber ich glaube, man darf jetzt schon sagen: Das wird mächtig!
Ein schnelleres und moderneres Backend
API und MCP waren zwar unser grösster Schwerpunkt, aber natürlich nicht die einzigen Themen. Ihr kennt uns. Der Berg
an Arbeit ist riesig und wenn neun Leute vier Tage lang gemeinsam in einem Raum sitzen, passiert nebenbei dann doch
noch das eine oder andere.
Schnellere Hierarchien
Bereits im Vorfeld war ein neuer Hierarchy Helper entstanden, den ich schon lange umsetzen wollte. Er nutzt
rekursive Common Table Expressions, sofern die Datenbank sie unterstützt. Dadurch lassen sich hierarchische Daten
mit deutlich weniger und wesentlich schnelleren Datenbankabfragen ermitteln als mit der bisherigen Kombination aus
iterativen Abfragen und UNION-Statements.
Davon profitieren nicht nur die Baumansichten im Backend, sondern beispielsweise auch Navigationen und Sitemaps.
Also überall dort, wo Contao sich durch einen Baum hangeln muss. Die Baumansichten laden dadurch bis zu fünfmal
schneller. Und weil wir Contao sind, bleibt für alte Datenbanksysteme natürlich ein Fallback auf die bisherige
Implementierung erhalten.
Weniger MooTools, mehr Komfort
Sebastian setzt seinen persönlichen Feldzug gegen die letzten MooTools-Abhängigkeiten konsequent fort. Die
Drag-and-drop-Funktion im Dateimanager ist bereits auf Stimulus umgestellt und auch der TableWizard wurde praktisch
vollständig neu gebaut. Das ist unter anderem die Grundlage für unser Tabellen-Inhaltselement und bekommt dabei
nicht bloss eine modernere technische Basis, sondern auch gleich haufenweise neue Funktionen: Spalten lassen sich
sortieren, Zeilen komfortabel hinzufügen oder entfernen und die einzelnen Zellen per Tastatur navigieren. Sogar die
Bearbeitung mit einem Rich-Text-Editor innerhalb der Tabelle ist vorgesehen. Ein Tabellen-Inhaltselement, das
plötzlich richtig Spass machen könnte. Wer hätte das gedacht?
Und wenn man schon dabei ist: Auch der ListWizard, auf dem das Listen-Inhaltselement aufbaut, wird deutlich
mächtiger. Im Widget lassen sich künftig verschachtelte Listen erstellen und der ListWizard selbst kann per Tastatur
bedient werden. Beide Arbeiten befinden sich noch im Review, zeigen aber sehr schön, dass das Ablösen alter Technik
nicht einfach Selbstzweck ist. Wenn wir den ganzen Kram ohnehin anfassen müssen, darf er danach bitte auch besser sein
als vorher.
Eine weitere Arbeit bringt echtes Drag-and-drop in den Seitenbaum und die Artikelansicht. Ja, richtig gelesen! Statt
Elemente auszuschneiden und an anderer Stelle wieder einzufügen, können Seiten und Artikel künftig direkt an die
gewünschte Position gezogen werden. Natürlich werden dabei die bestehenden Berechtigungen und die besonderen Regeln
für Startpunkte einer Website berücksichtigt.
Eine Zeitmaschine für die Frontend-Vorschau
Wer Inhalte für einen bestimmten Zeitpunkt vorbereitet, kennt das Problem: Ein Inhaltselement ist korrekt
konfiguriert, wird aber erst nächste Woche veröffentlicht. Um das Ergebnis zu kontrollieren, musste man bislang die
Veröffentlichungszeit vorübergehend ändern. Oder eine Woche warten. Beides eher so mässig praktisch.
Die Frontend-Vorschau erhält deshalb eine kleine Zeitmaschine. Dort lässt sich ein beliebiges Datum samt Uhrzeit
auswählen und Contao zeigt die Website so an, wie sie zu diesem Zeitpunkt aussehen wird. Nächsten Dienstag um 14:42
Uhr? Kein Problem. Redaktionen können geplante Veröffentlichungen damit endlich vorab prüfen, ohne dabei Inhalte,
Seiten, Artikel etc. zu sehen, welche eigentlich ausgeblendet bleiben sollten. Grossartig!
Präzisere Facetten in der Backend-Suche
Auch die Backend-Suche wurde verbessert. Bisher konnten die angezeigten Facetten Treffer suggerieren, auf welche die
angemeldete Person aufgrund ihrer Benutzergruppen gar keinen Zugriff hatte. Frustrierend, denn was bringt mir ein
Filter mit fünf Treffern, wenn ich keinen davon öffnen darf? Beim Indexieren wird deshalb neu ermittelt, welche
Gruppen ein Dokument sehen dürfen. Die Suche kann diese Information direkt berücksichtigen und zeigt nur noch jene
Facetten an, hinter denen sich tatsächlich erreichbare Ergebnisse befinden.
Das klingt nach einer kleinen Änderung, erforderte unter der Haube aber wichtige Grundlagen. Contao muss beim
Indexieren die Berechtigungen virtueller Benutzer prüfen können, obwohl dieser Vorgang auf der Kommandozeile und
damit ausserhalb eines normalen Backend-Requests stattfindet.
End-to-End-Tests
Nun zu einem Thema, das für Anwender:innen vermutlich nicht ganz so aufregend klingt, uns für die weitere Entwicklung
aber enorm wichtig war: Eine erste Grundlage für echte End-to-End-Tests war bereits vorbereitet. Während des
Treffens haben wir sie gemeinsam in das Contao-Monorepository integriert, erweitert und vor allem mit echten Tests
gefüttert.
Contao verfügt selbstverständlich schon lange über tausende automatisierte Tests. Unit-Tests prüfen kleine,
isolierte Bausteine und unsere Funktionstests testen grössere Teile im Zusammenspiel mit Symfony und einer
Datenbank. Klingt doch eigentlich schon ziemlich gut. Was soll jetzt noch dieses End-to-End sein?
Was uns bisher fehlte, war eine wiederverwendbare Möglichkeit, eine vollständige Contao-Installation vom ersten bis
zum letzten Schritt automatisiert zu testen. Also nicht nur ein paar Services in einem künstlichen Test-Setup,
sondern eine echte Installation. Mit allem drum und dran.
Genau das kann die neue Infrastruktur. Sie erstellt eine isolierte Contao Managed Edition, installiert deren
Composer-Abhängigkeiten, stellt automatisch die benötigte Datenbank per Docker bereit, führt die Migrationen aus,
lädt definierte Testdaten und startet einen lokalen Webserver. Anschliessend kann sie über Symfony BrowserKit oder
mit Playwright in einem echten Browser bedient werden. Der Test sieht damit nicht bloss einzelne Services, sondern
Contao so, wie es später auch tatsächlich eingesetzt wird.
Die ersten migrierten Tests zeigen den Mehrwert sehr schön. Routing-Tests senden jetzt echte HTTP-Anfragen an eine
vollständig konfigurierte Installation. Andere Tests melden sich mit Demo-Benutzern im Backend an, erstellen eine
Website, laden ein Bild hoch, wählen es in einem Inhaltselement aus und prüfen anschliessend das Resultat im
Frontend. Ein kleiner Roboter, der Contao installiert und danach im Backend herumklickt. Ich find's schon ziemlich
cool.
Sebastian hat sich die neue Infrastruktur direkt geschnappt und arbeitet daran, unsere neue API vollständig von Ende
zu Ende zu testen. Dabei haben die Tests bereits mehrere echte Fehler sichtbar gemacht. Genau dafür ist die
Infrastruktur da: Wir kennen die noch vorhandenen Lücken, bevor wir das Ganze auf die Community loslassen.
Auch beim RowWizard haben neue End-to-End-Tests direkt zwei echte Fehler beim Kopieren von Zeilen gefunden. Besser
kann eine neue Testinfrastruktur ihren Wert eigentlich kaum beweisen.
Das klingt nach ziemlich viel Aufwand für einen Test. Ist es auch. Deshalb werden Installation, Testdaten, Dateien
und Browser-Treiber über wiederverwendbare Pakete verwaltet. Das Framework ist dabei nicht nur für den Core gedacht.
Extension-Entwickler:innen können es in ihre Erweiterung einbinden und erhalten eine vollständige Contao Managed
Edition mit Datenbank, Fixture-Support und Dateien. Damit lässt sich eine Erweiterung automatisiert in allen
unterstützten Contao-Versionen testen. Jeder Test erhält einen definierten Zustand und hinterlässt keine Daten für
den nächsten. Perspektivisch können mehrere Tests sogar parallel laufen. Zumindest sobald wir unsere CI mit genügend
Ressourcen beworfen haben.
Warum das für API und MCP entscheidend ist
Bei einer klassischen Backend-Funktion können wir viele Fehler bereits in einem isolierten Test erkennen. Eine
API-Anfrage durchläuft dagegen Routing, Firewall, Authentifizierung, Berechtigungsprüfungen, Serialisierung und die
eigentliche Contao-Logik. MCP setzt noch eine weitere Ebene darauf. Jede einzelne Komponente kann für sich komplett
korrekt funktionieren und das Gesamtsystem trotzdem wegen irgendeiner unscheinbaren Konfigurationsabweichung
explodieren. Software halt.
End-to-End-Tests geben uns die Möglichkeit, genau jene Abläufe abzubilden, die später auch ein API-Client oder
MCP-Assistent nutzt: anmelden, erlaubte Ressourcen abrufen, eine Operation ausführen und das Resultat prüfen. Und
natürlich auch den umgekehrten Fall. Ein anderer Benutzer ohne die nötigen Berechtigungen darf dieselbe Operation
eben gerade nicht ausführen. Tests für «darf nicht» sind mindestens genauso wichtig wie Tests für «funktioniert».
Care-Paket
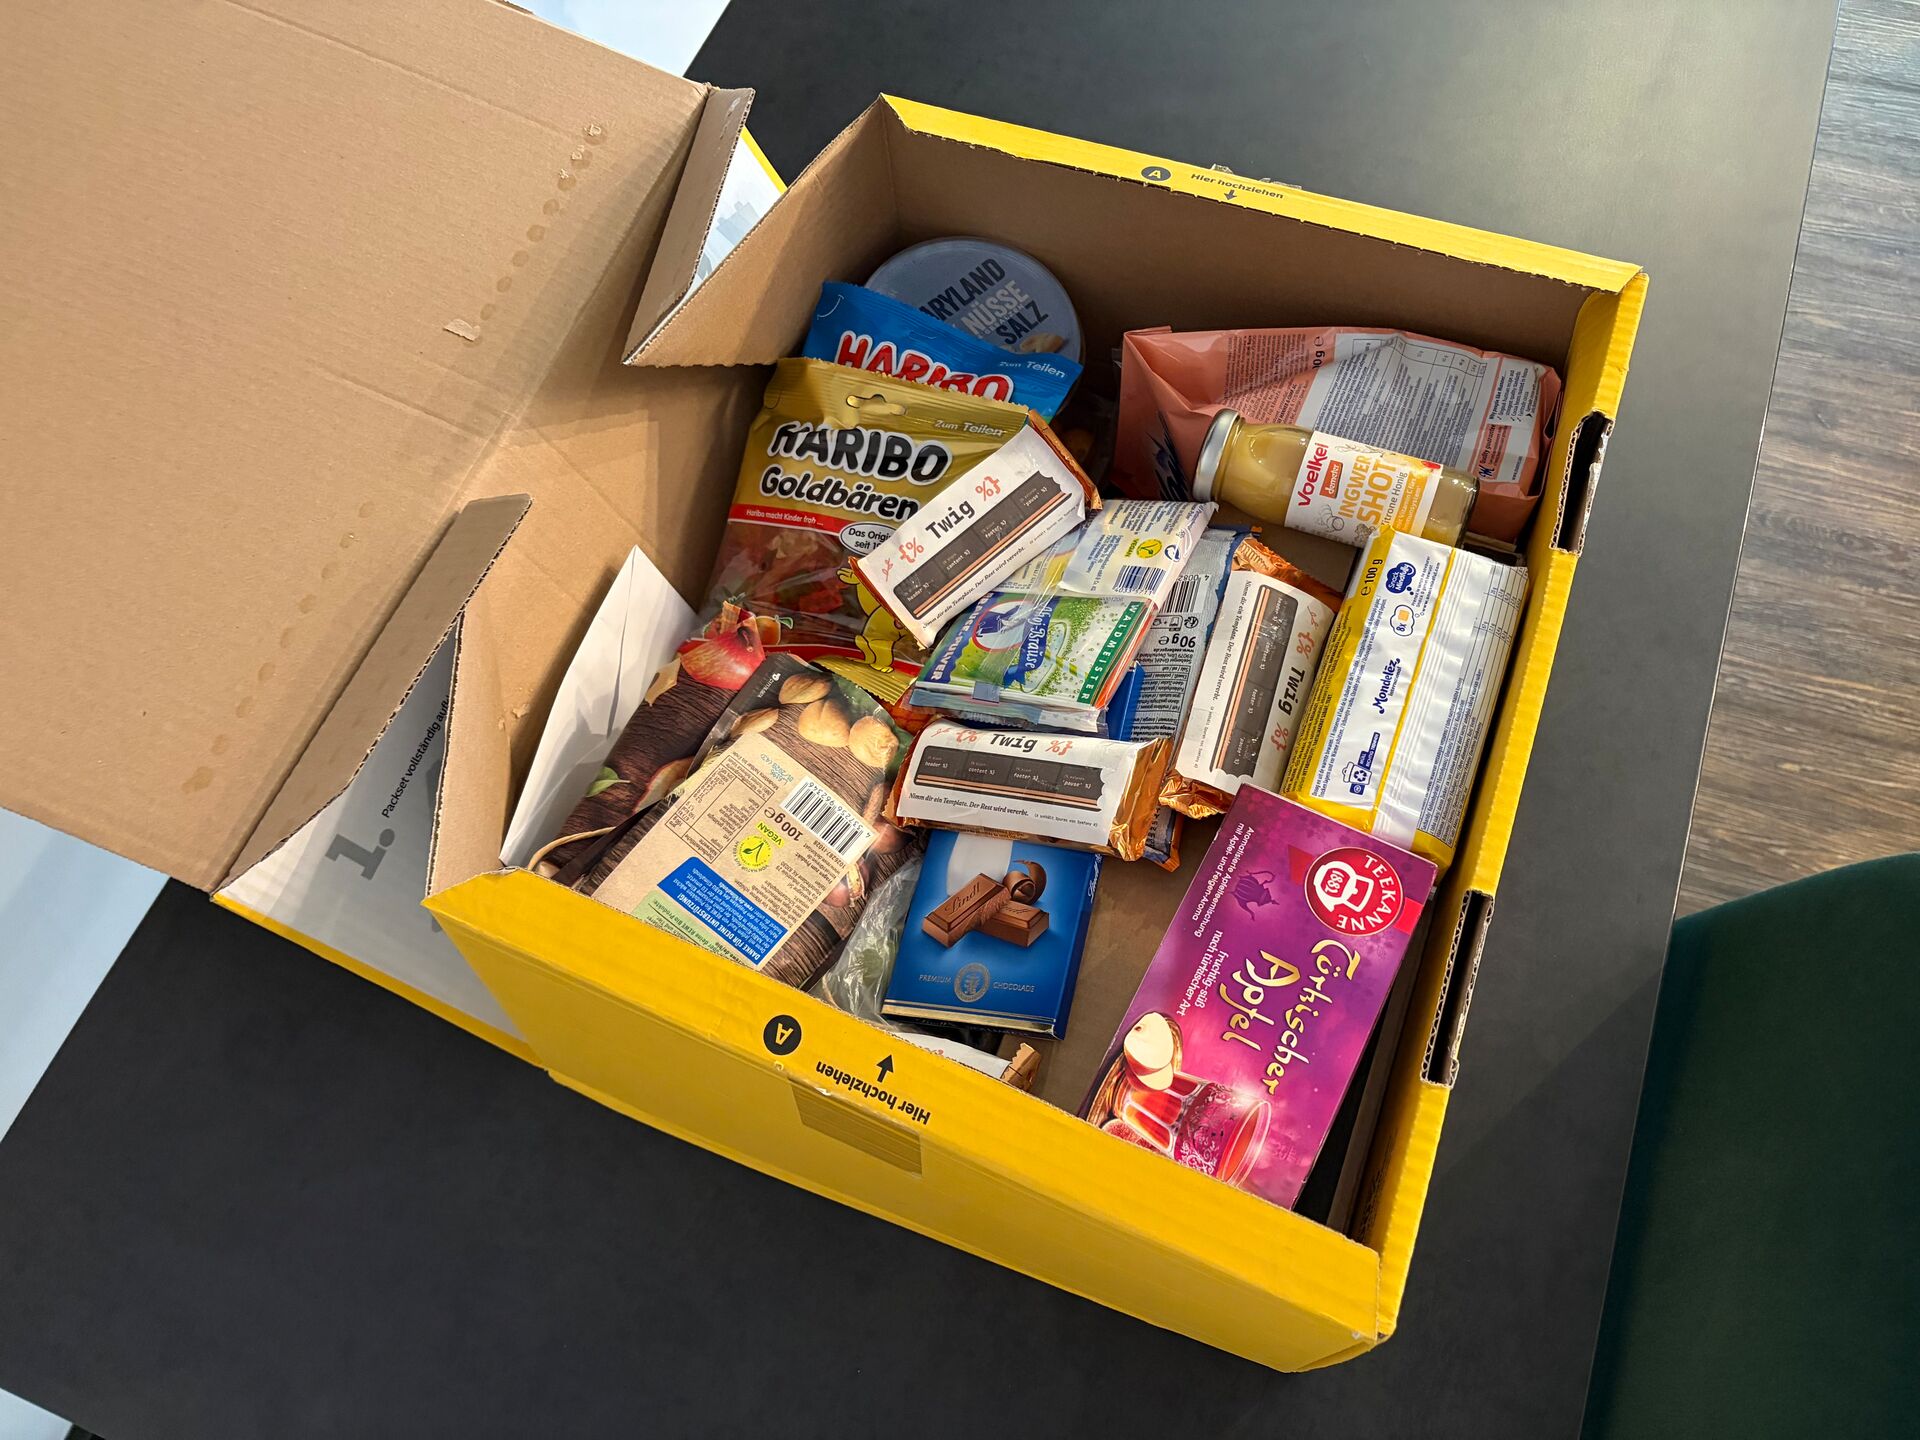
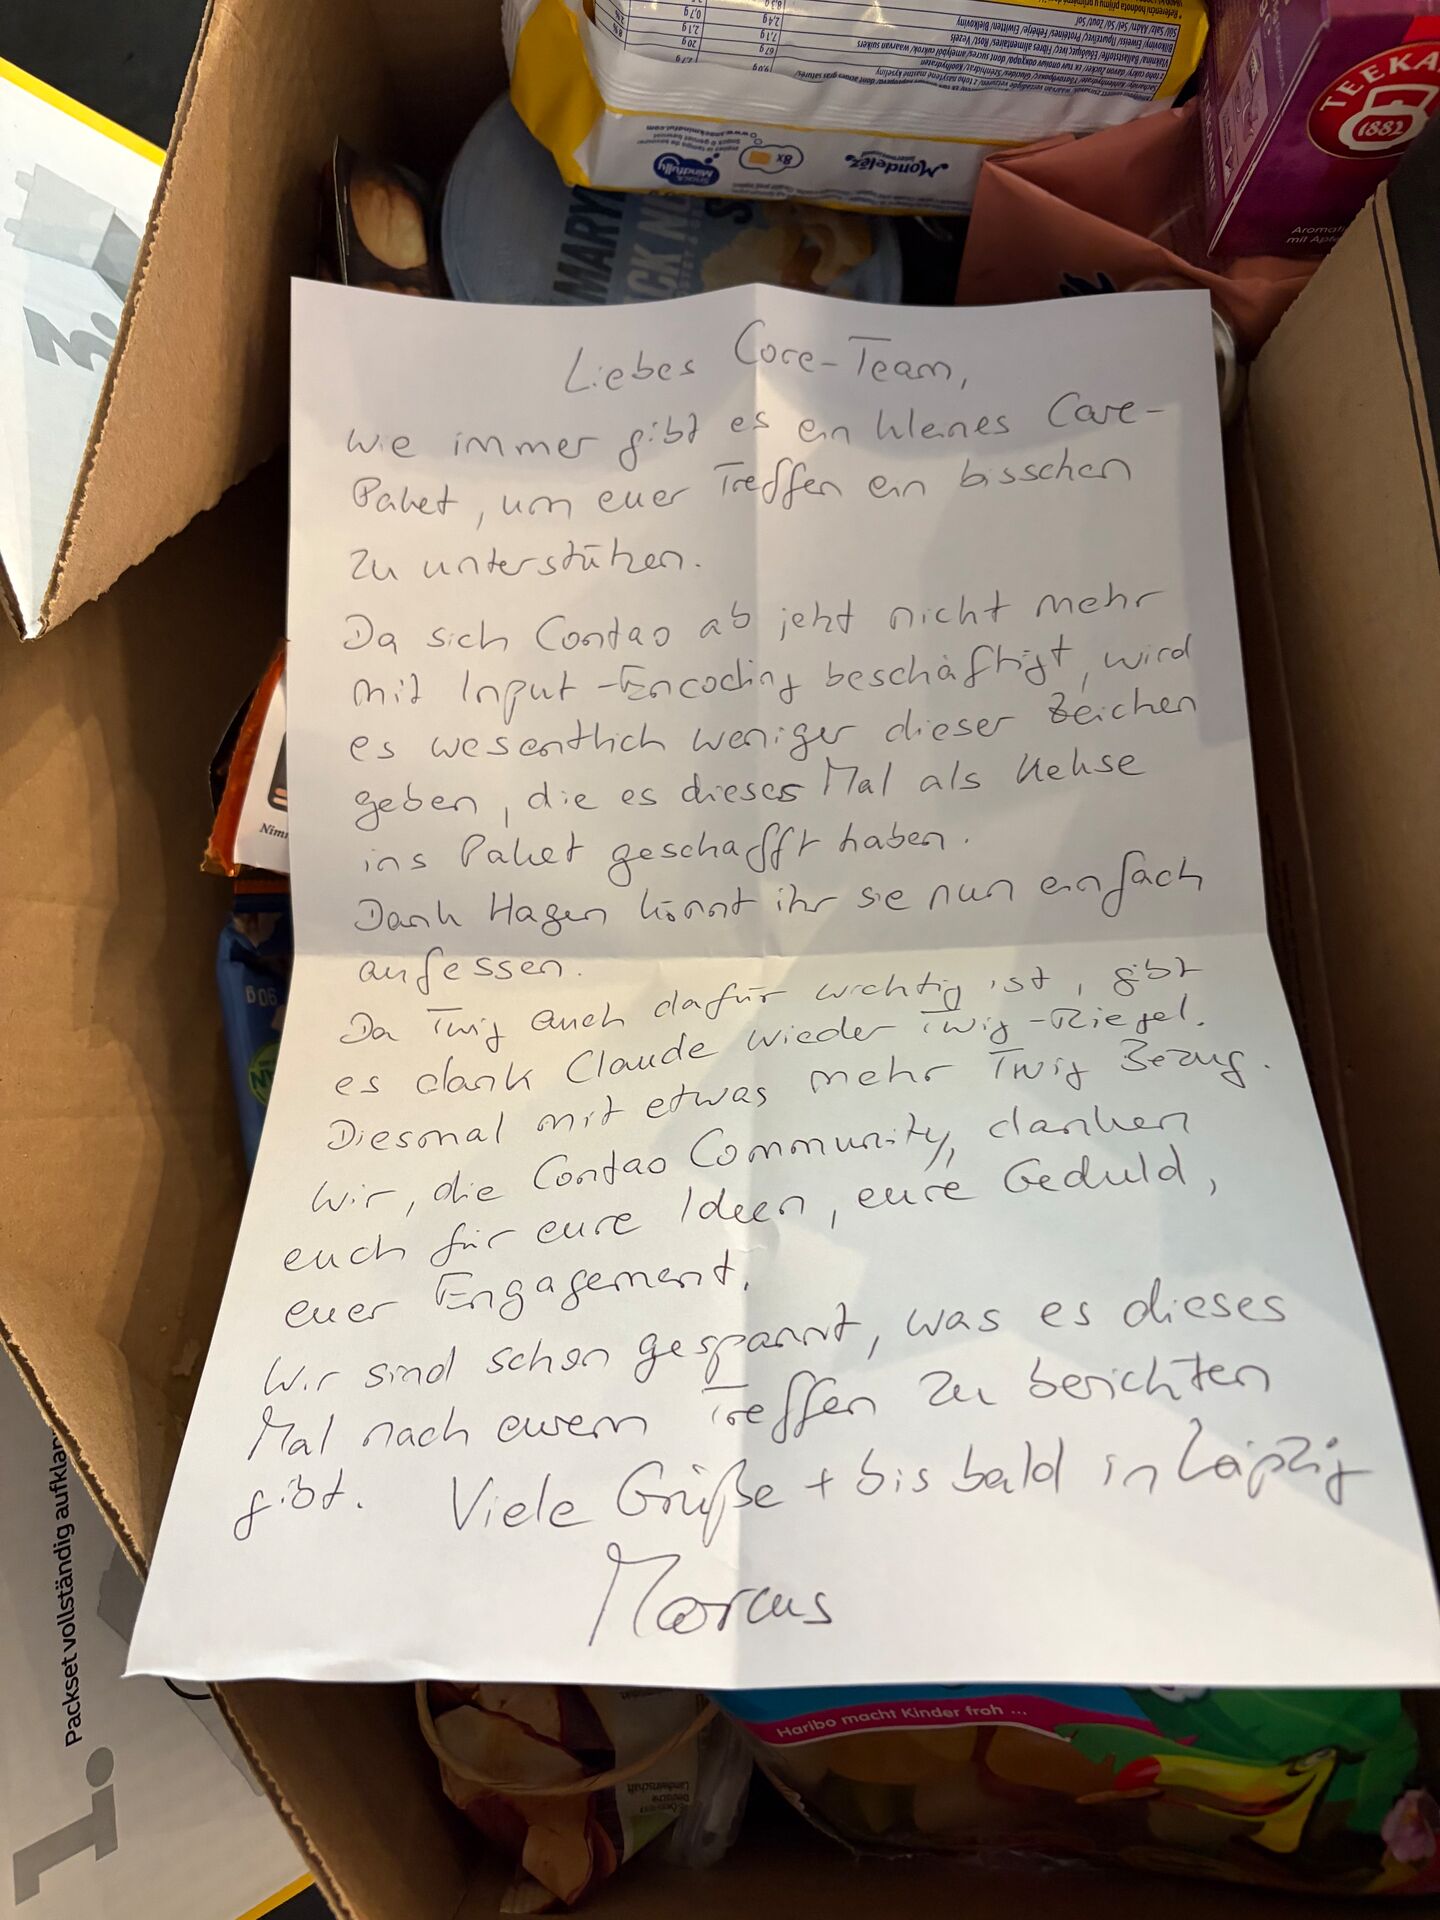
Auch dieses Mal hat das Projektteam wieder an uns gedacht und Marcus hat ein Care-Paket mit allem zusammengestellt,
was neun Entwickler für vier Tage Contao brauchen. Also hauptsächlich Nervennahrung.
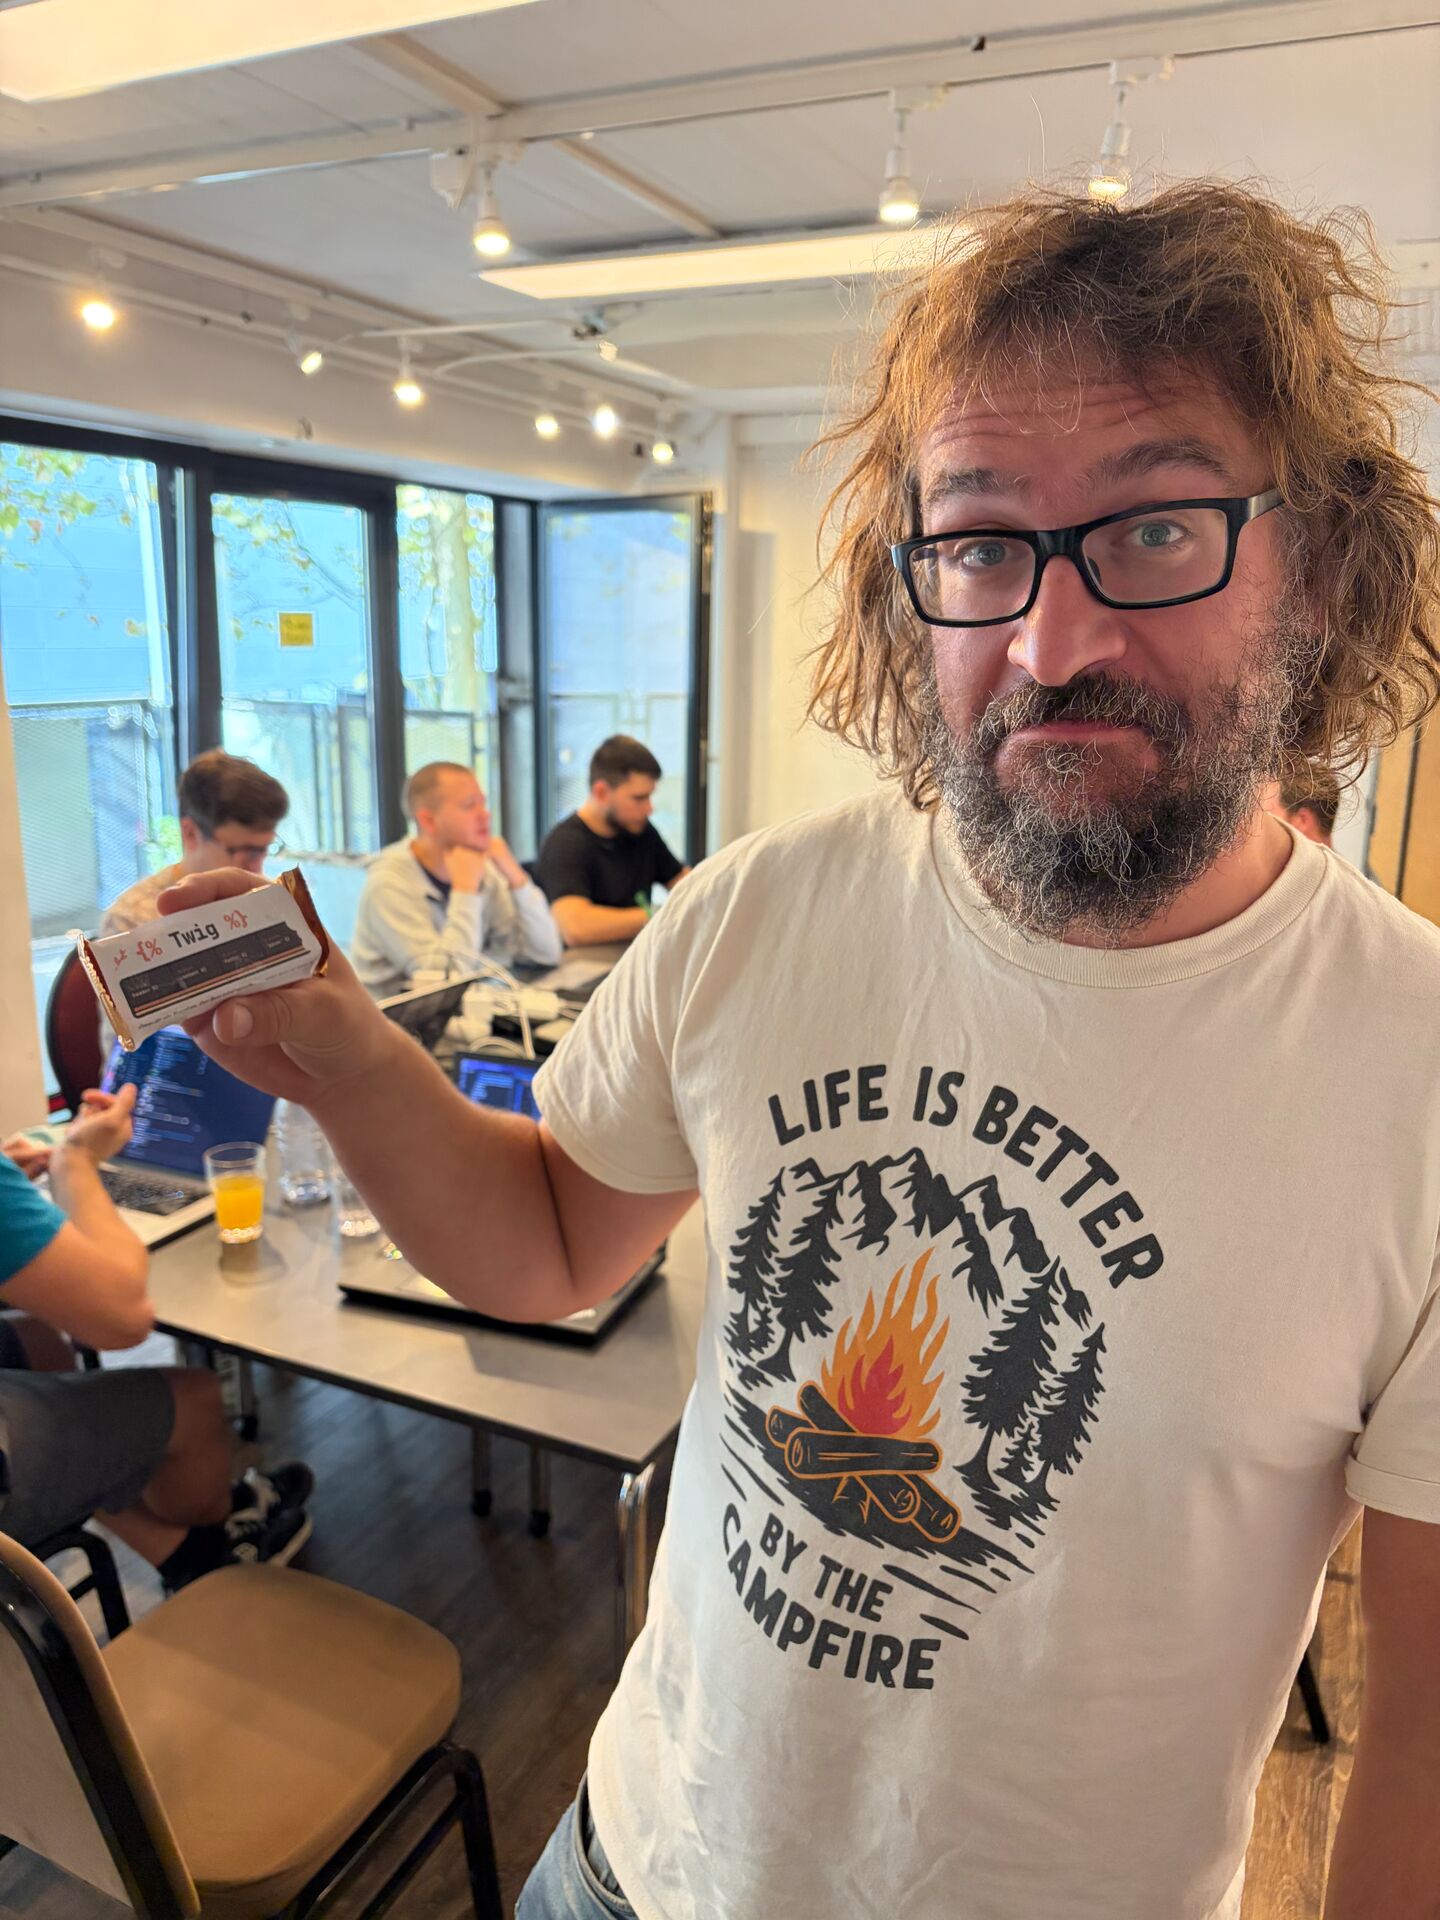
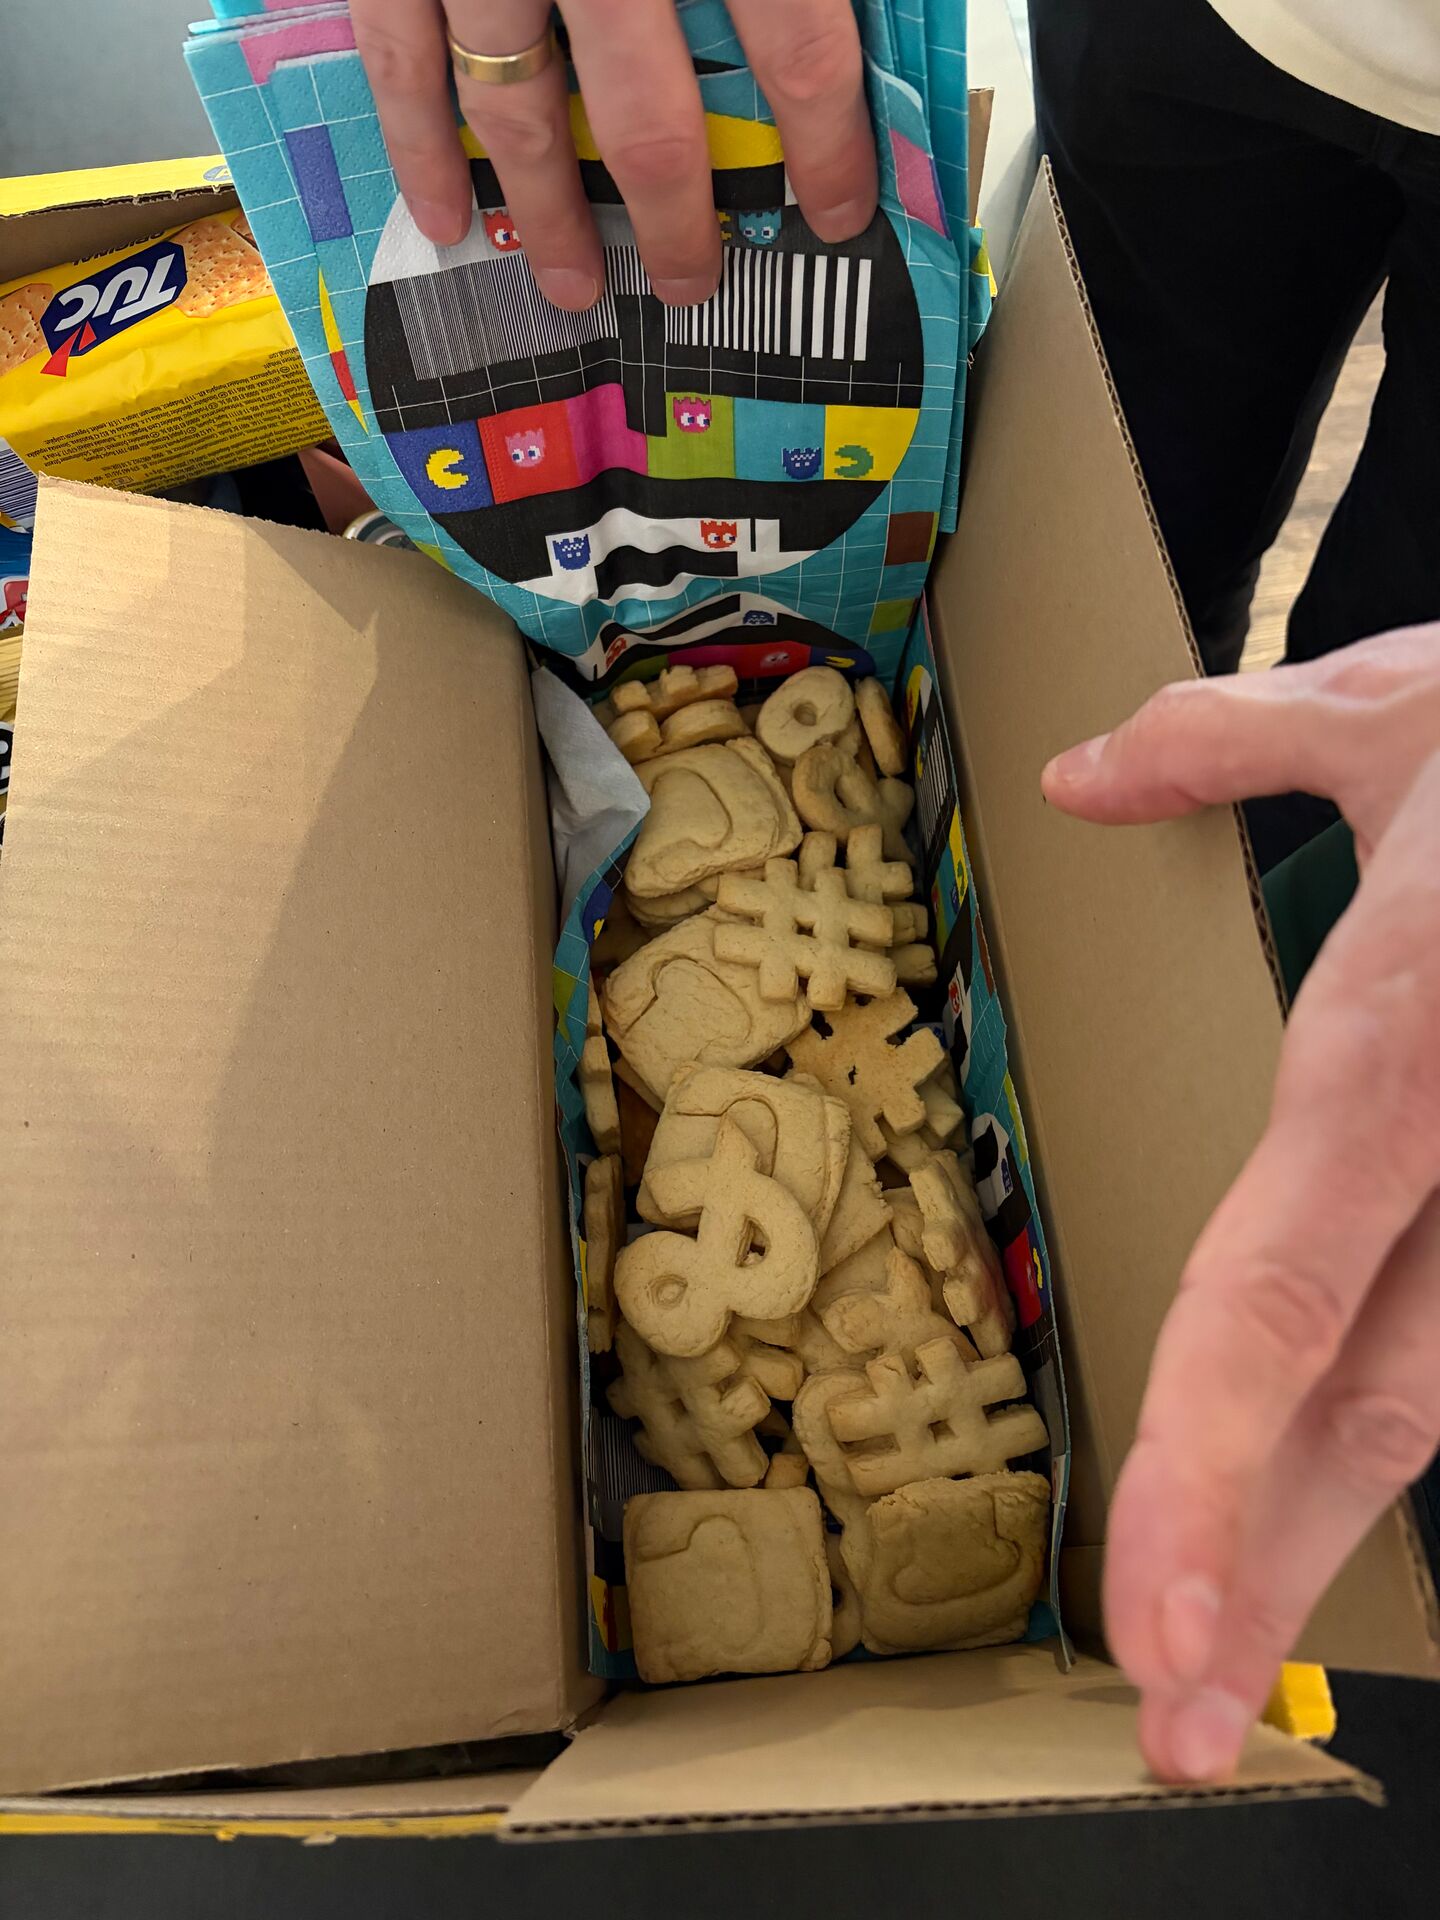
Passend zum Abschied vom Input-Encoding gab es dank Hagen essbare Sonderzeichen und dank Claude erneut Twig-Riegel,
dieses Mal mit noch etwas mehr Twig-Bezug. Vielen herzlichen Dank an dich, lieber Marcus, für die Organisation und
den persönlichen Brief sowie an Hagen, das ganze Projektteam und alle weiteren Beteiligten! Fotos findet ihr im
Anhang zum Blogpost.
Ausblick auf Contao 6.1
Und wann könnt ihr das alles nutzen? Die meisten der hier vorgestellten Funktionen sollen mit Contao 6.1 im Februar
2027 veröffentlicht werden. Bis dahin gibt es selbstverständlich noch einiges zu reviewen, zu testen und an der
einen oder anderen Stelle zu verfeinern. Gerade bei API und MCP betreten wir in Contao Neuland und wollen die neuen
Möglichkeiten deshalb mit der nötigen Sorgfalt entwickeln.
Februar ist dir zu weit weg? Perfekt, denn für Fragen, Ideen und selbstverständlich auch Bedenken musst du gar nicht
so lange warten. Komm einfach zum Contao Summit am 15. und 16. Oktober in Leipzig!
Dort möchten wir nicht nur Ergebnisse präsentieren, sondern gemeinsam darüber diskutieren, wie Contao in dieser
neuen Realität aussehen soll. Ich glaube, es gab selten einen besseren Zeitpunkt, um als Community zusammenzukommen
und sich auszutauschen. Also wirklich: Komm nach Leipzig!
That's all Folks!
– Yanick




Kommentare
Kommentar von Thomas (koertho) |
Danke für eure Mühe!
Kommentar von Christian |
Kommentar von Franko |
Dies nicht allein bez. Ausblick, sondern vor allem mit verständlichen, technischen Details in Verbindung mit Gründen für deren Implementierung.
Chapeau
Kommentar von Detlef |
wie immer wunderbar geschrieben und zu lesen. Vielen Dank an alle für eure Arbeit.
Kommentar von Julle |
Einen Kommentar schreiben